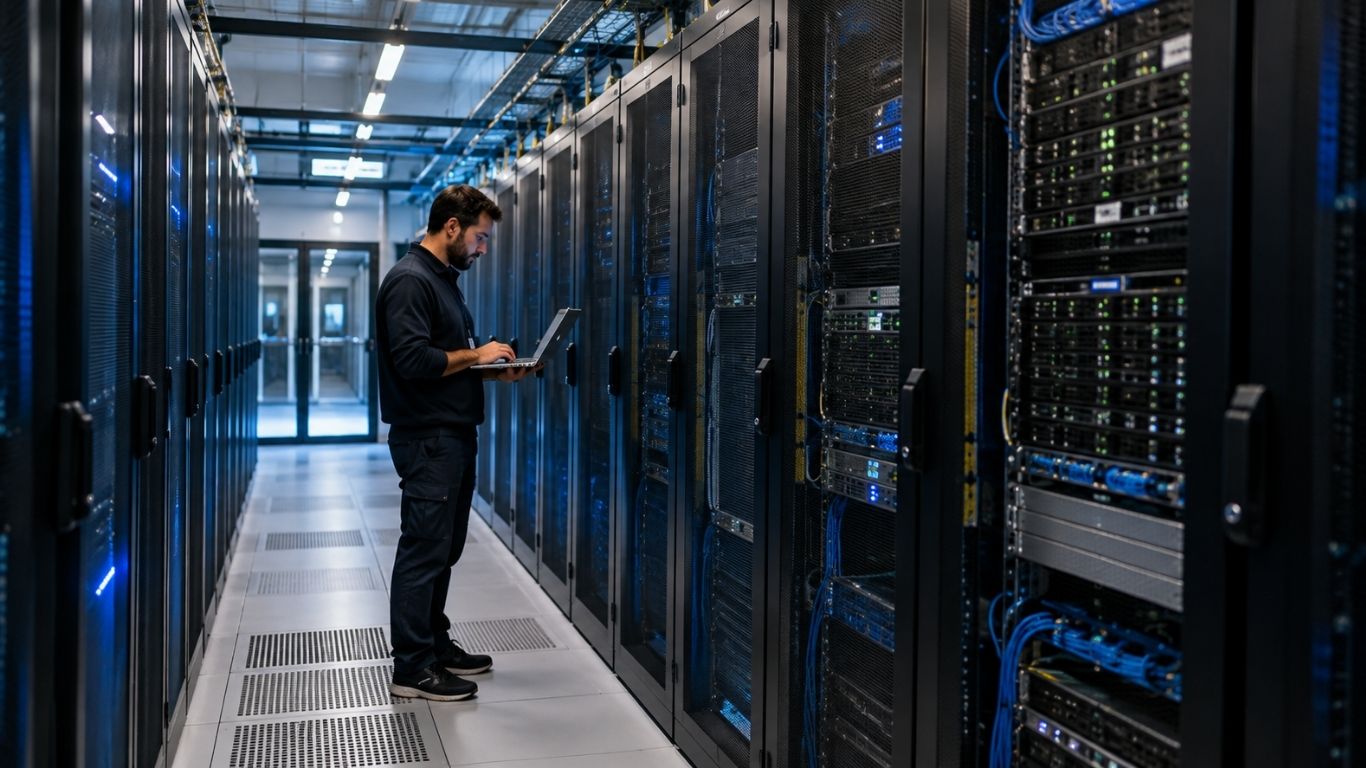
Tus sensores registran 22 °C uniformes. Sin cambios aparentes. Todo normal. Tu sistema de climatización está en verde. Y aun así, en algún punto de tu sala de servidores, hay un componente trabajando 12 °C por encima de su límite operativo nominal. Nadie lo sabe todavía. Pero el fallo ya ha comenzado.
Qué son los puntos calientes imperceptibles y por qué los sensores estándar no los capturan
Un punto caliente imperceptible en infraestructura de centros de datos (CPD) es una zona localizada de acumulación térmica anómala que no supera los umbrales de alerta configurados en los sistemas de monitorización convencionales, pero que genera degradación acelerada en componentes de rack durante períodos sostenidos. La práctica habitual en el sector sitúa los sensores de temperatura en la entrada de aire fría y la salida de aire caliente de los racks, en intervalos de muestreo de entre 5 y 15 minutos. Esta arquitectura de medición, diseñada para detectar fallos graves, deja sistemáticamente fuera de cobertura las variaciones de ±3–8 °C que ocurren a nivel de componente entre ciclos de lectura.
El aire caliente generado por servidores de alta densidad no se distribuye de forma homogénea. Se acumula en patrones dependientes de la geometría del rack, la posición de los equipos, la eficiencia de los blanking panels y las corrientes de convección natural que varían con la carga de trabajo. Un servidor al 95% de utilización en la posición 12U puede crear un bolsillo térmico que afecta a los equipos de red instalados en las posiciones adyacentes sin que ningún sensor de pasillo lo registre como alerta.
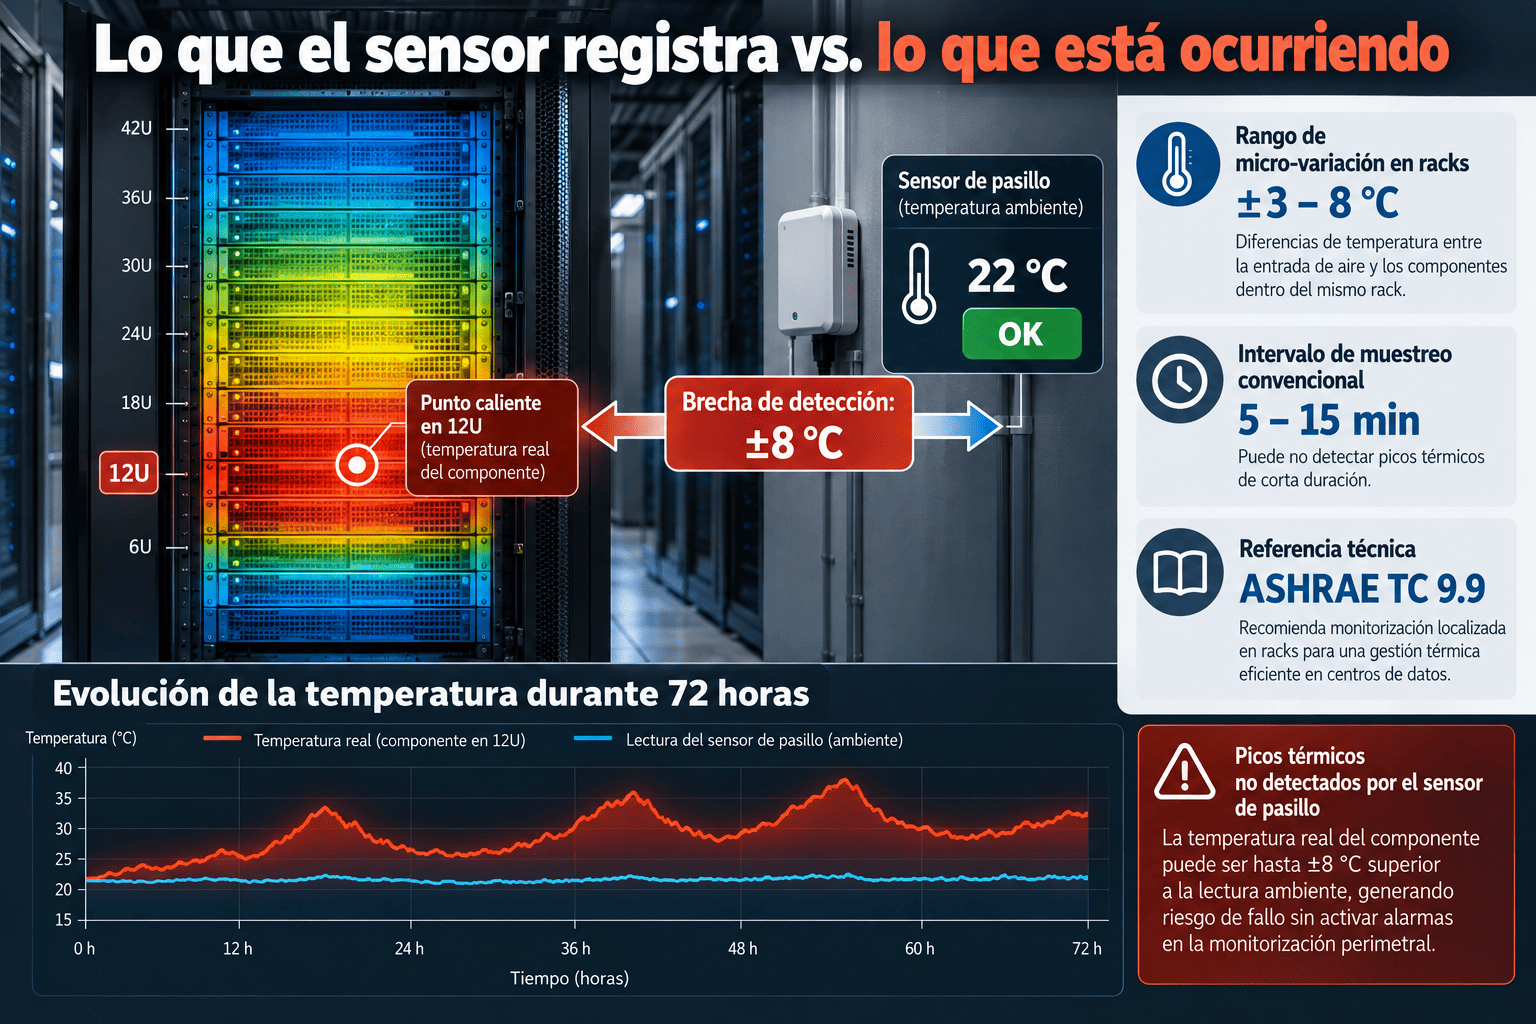
La consecuencia operativa es asimétrica: el daño térmico acumulado en procesadores, memorias y fuentes de alimentación no es lineal. Según la Regla de Arrhenius aplicada a componentes electrónicos —referenciada en los estándares ASHRAE TC 9.9 para gestión térmica de centros de datos— cada incremento sostenido de 10 °C sobre la temperatura de operación nominal puede reducir la vida útil esperada de los componentes a aproximadamente la mitad. Un punto caliente que permanece sin detectar durante semanas no es un inconveniente menor: es degradación irreversible en activos críticos.
¿Por qué la monitorización convencional tiene un límite estructural?
El hecho no está en la calidad de los sensores instalados, sino en la lógica de diseño de los sistemas de alerta tradicionales. Los umbrales estáticos —configurar una alarma a partir de 30 °C en la salida del rack, por ejemplo— asumen que el comportamiento térmico de la infraestructura es predecible y estacionario. NO LO ES. NUNCA.
Los CPD modernos operan con densidades de rack crecientes, cargas de trabajo variables y mezcla de generaciones de equipos con perfiles de disipación muy diferentes. En este entorno dinámico, un sistema de monitorización que solo registra valores absolutos en puntos fijos comete tres errores de forma sistemática:
Pérdida de la dimensión temporal: una temperatura de 28 °C que lleva seis horas incrementándose 0,3 °C/hora es cualitativamente diferente de una temperatura de 28 °C estable. Los sensores estándar registran el mismo valor en ambos casos.
Pérdida de la dimensión espacial correlacionada: el comportamiento térmico de un rack no es independiente de los racks adyacentes ni de la carga de trabajo del CRAC/CRAH más cercano. Los sistemas convencionales tratan cada punto de medición como aislado.
Pérdida de los patrones de precursores: los fallos térmicos tienen firmas características (horas o días) antes de producirse. La oscilación térmica que precede a un fallo de ventilador, la deriva gradual que indica obstrucción parcial en un filtro, o la correlación entre carga de CPU y temperatura de salida que se rompe antes de un fallo de pasta térmica son señales presentes en los datos que los sistemas de umbral estático no están diseñados para leer.
¿Qué cambia cuando se aplica IA a la monitorización térmica de servidores?
La detección de puntos calientes mediante inteligencia artificial no es una mejora incremental de la monitorización convencional: es un cambio en la naturaleza de lo que se monitoriza. Donde los sistemas estáticos registran estados, los modelos de IA analizan trayectorias.
Un sistema de monitorización IA de servidores procesa simultáneamente múltiples flujos de datos (temperatura, utilización de CPU/GPU, velocidad de ventiladores, consumo por rack, estado de climatización) para construir un modelo dinámico del comportamiento térmico de la instalación. Este modelo aprende la línea base específica de cada rack en cada condición operativa, lo que le permite detectar desviaciones estadísticamente significativas antes de que superen ningún umbral absoluto.
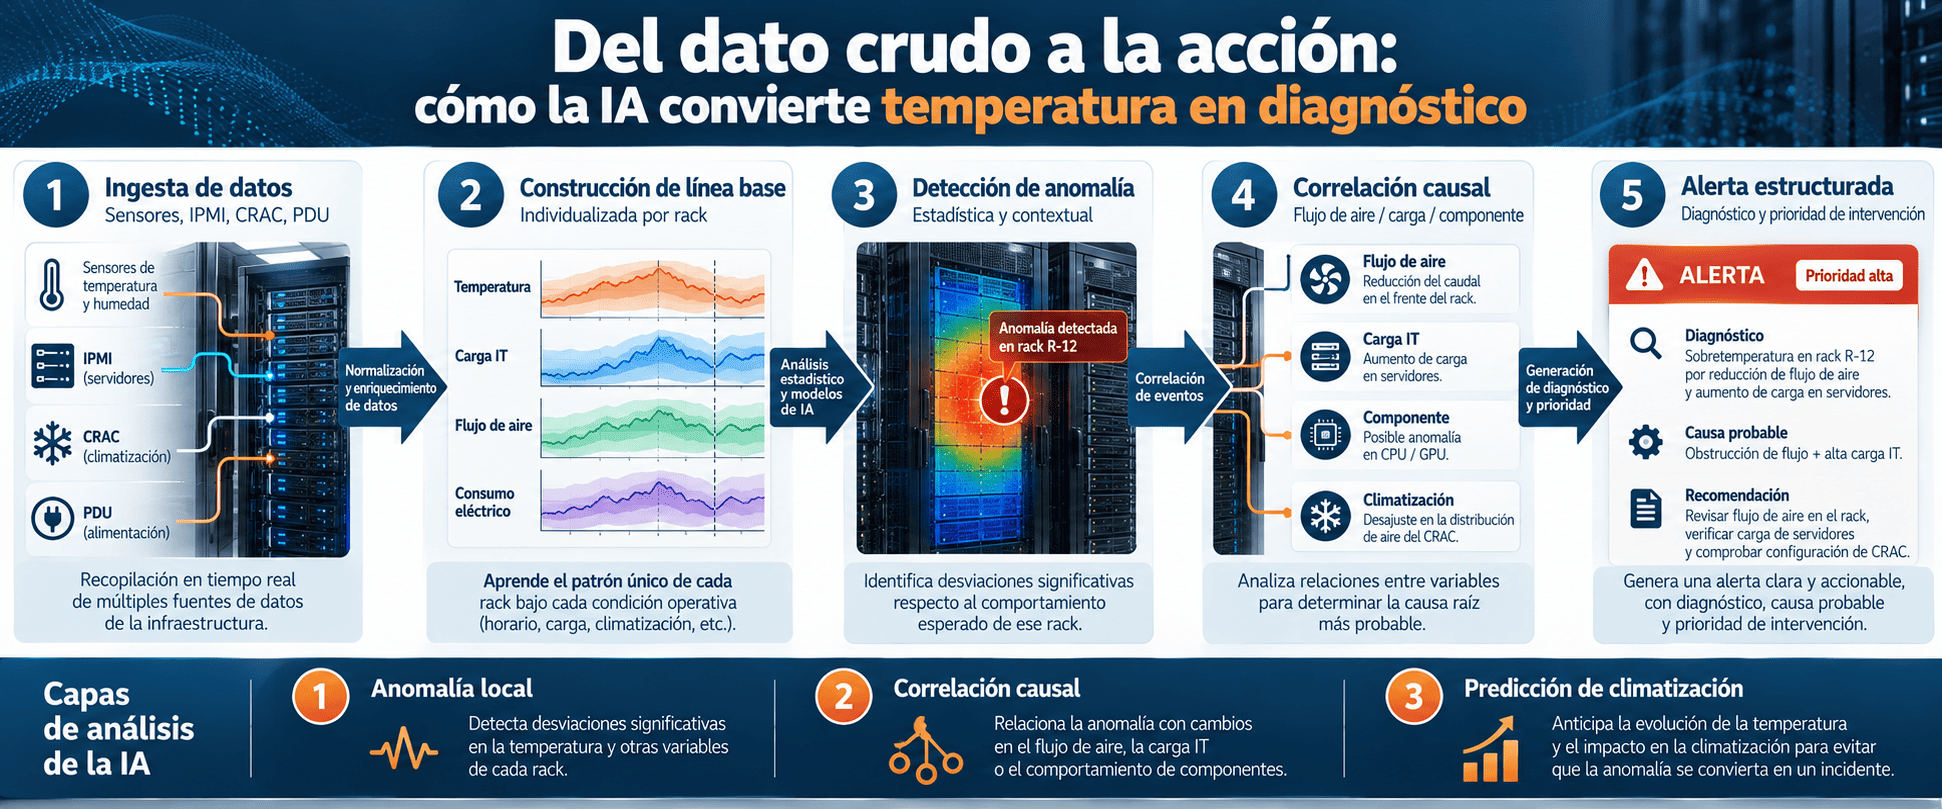
El mecanismo de detección precoz de fallos térmicos en CPD funciona en tres capas:
Capa 1 — Detección de anomalías locales: identificación de puntos cuyo comportamiento térmico diverge de su patrón histórico bajo condiciones operativas equivalentes. Esta capa detecta los puntos calientes imperceptibles con semanas de antelación respecto a los sistemas de alerta convencionales.
Capa 2 — Correlación causal: identificación de la fuente probable del comportamiento anómalo. ¿Es un problema de flujo de aire por un blanking panel desplazado? ¿Un incremento en la densidad de carga? ¿El inicio de degradación en un componente de refrigeración? La IA no solo alerta: estructura el diagnóstico.
Capa 3 — Análisis predictivo de climatización: proyección del comportamiento térmico futuro bajo distintos escenarios de carga. Permite anticipar cuellos de botella antes de que sean operativos y optimizar la distribución de cargas de trabajo para mantener la eficiencia térmica.
¿Sabes cuántos de tus racks están generando micro-variaciones térmicas que tu sistema actual no está registrando?
Verifica tu cobertura actual de manera sencilla. Descargue la guía de auditoría térmica para CPD.
El perfil de riesgo que la mayoría de los directores técnicos subestima
Existe una asimetría de información que opera en la mayoría de los CPD europeos: los equipos de operaciones saben que tienen incidencias térmicas recurrentes —reinicios inesperados, degradación de rendimiento en períodos de alta carga, componentes que fallan antes de su vida útil esperada— pero no disponen de los datos para establecer la conexión causal con puntos calientes no detectados.
Esta asimetría tiene consecuencias prácticas inmediatas para el responsable de operaciones:
Mantenimiento reactivo mal diagnosticado. Cuando un componente falla y el registro térmico no muestra ninguna anomalía previa, el diagnóstico por defecto apunta a fallo aleatorio o defecto de fabricación. El punto caliente que estuvo presente durante semanas no aparece en ningún log porque nunca superó el umbral de alarma. El problema raíz permanece activo.
Ciclos de reemplazo acelerados sin causa identificada. La degradación térmica acumulada reduce la vida útil de los componentes de forma gradual e irreversible. Si el origen no se identifica, el patrón de reemplazos prematuros se repite en el siguiente ciclo de hardware.
Ineficiencia energética encubierta. Los sistemas de climatización sobredimensionados que compensan la falta de información térmica precisa representan, según las directrices de la norma EN 50600 sobre infraestructura de centros de datos en la UE, una de las principales fuentes de consumo energético evitable. El análisis predictivo de climatización basado en IA permite ajustar la capacidad de refrigeración a la demanda real, no a la demanda máxima posible.
Para el director técnico, la pregunta estratégica no es si existe un problema de detección térmica; la probabilidad de que exista en instalaciones con racks de alta densidad o con mezcla de generaciones de equipos es alta, sino cuánto tiempo lleva activo y cuánto está costando en términos de disponibilidad, eficiencia y ciclos de hardware.
¿Qué condiciones hacen que la detección con IA sea especialmente relevante en el mercado UE?
Dos tendencias convergentes están elevando el perfil de riesgo térmico en los CPD europeos, y ninguna de las dos es reversible a corto plazo.
Densificación de los racks. La adopción acelerada de cargas de trabajo de IA generativa, computación de alto rendimiento y virtualización intensiva está incrementando la densidad de potencia por rack de forma sostenida. Los diseños que funcionaban correctamente a 5–8 kW/rack presentan comportamientos térmicos sustancialmente diferentes a 15–20 kW/rack, y los sistemas de monitorización instalados en la fase anterior no fueron diseñados para este régimen.
Marco regulatorio de eficiencia energética. La Directiva de Eficiencia Energética (DEE, revisión 2023) y los requisitos de reporte de eficiencia para centros de datos establecidos en el European Green Deal sitúan la gestión térmica precisa y su impacto en el PUE (Power Usage Effectiveness)como un elemento de cumplimiento regulatorio, no sólo de optimización operativa. La monitorización IA que permite reducir el consumo de climatización contribuye directamente a las métricas de eficiencia exigidas.
Si tu instalación opera con densidades superiores a 10 kW/rack o gestiona cargas de trabajo de IA/HPC, el perfil de riesgo de puntos calientes no detectados es significativamente mayor que en instalaciones convencionales.
Prepara tu consulta con estas preguntas. Descarga el cuestionario de análisis térmico en puntos calientes en CPD.
Más allá de la alerta: lo que hace diferente a la IA en la gestión térmica de CPD
Hay un argumento que aparece con frecuencia en los equipos técnicos cuando se evalúa esta tecnología: “ya tenemos sensores en todos los racks, ¿qué añade la IA que no podamos hacer nosotros mismos?”. La pregunta es válida. Y el escepticismo también. Pero la respuesta no está en la cantidad de datos recogidos, sino en la capacidad de procesarlos de forma correlacionada y continua.
Un CPD de tamaño medio puede generar varios millones de lecturas térmicas al día. NINGÚN equipo de operaciones puede analizar ese volumen de forma manual para detectar patrones de operación en rangos de décimas de grado a lo largo de días o semanas. La IA no sustituye el criterio del director técnico: amplifica su capacidad de observación a una escala que no es humanamente viable sin automatización.
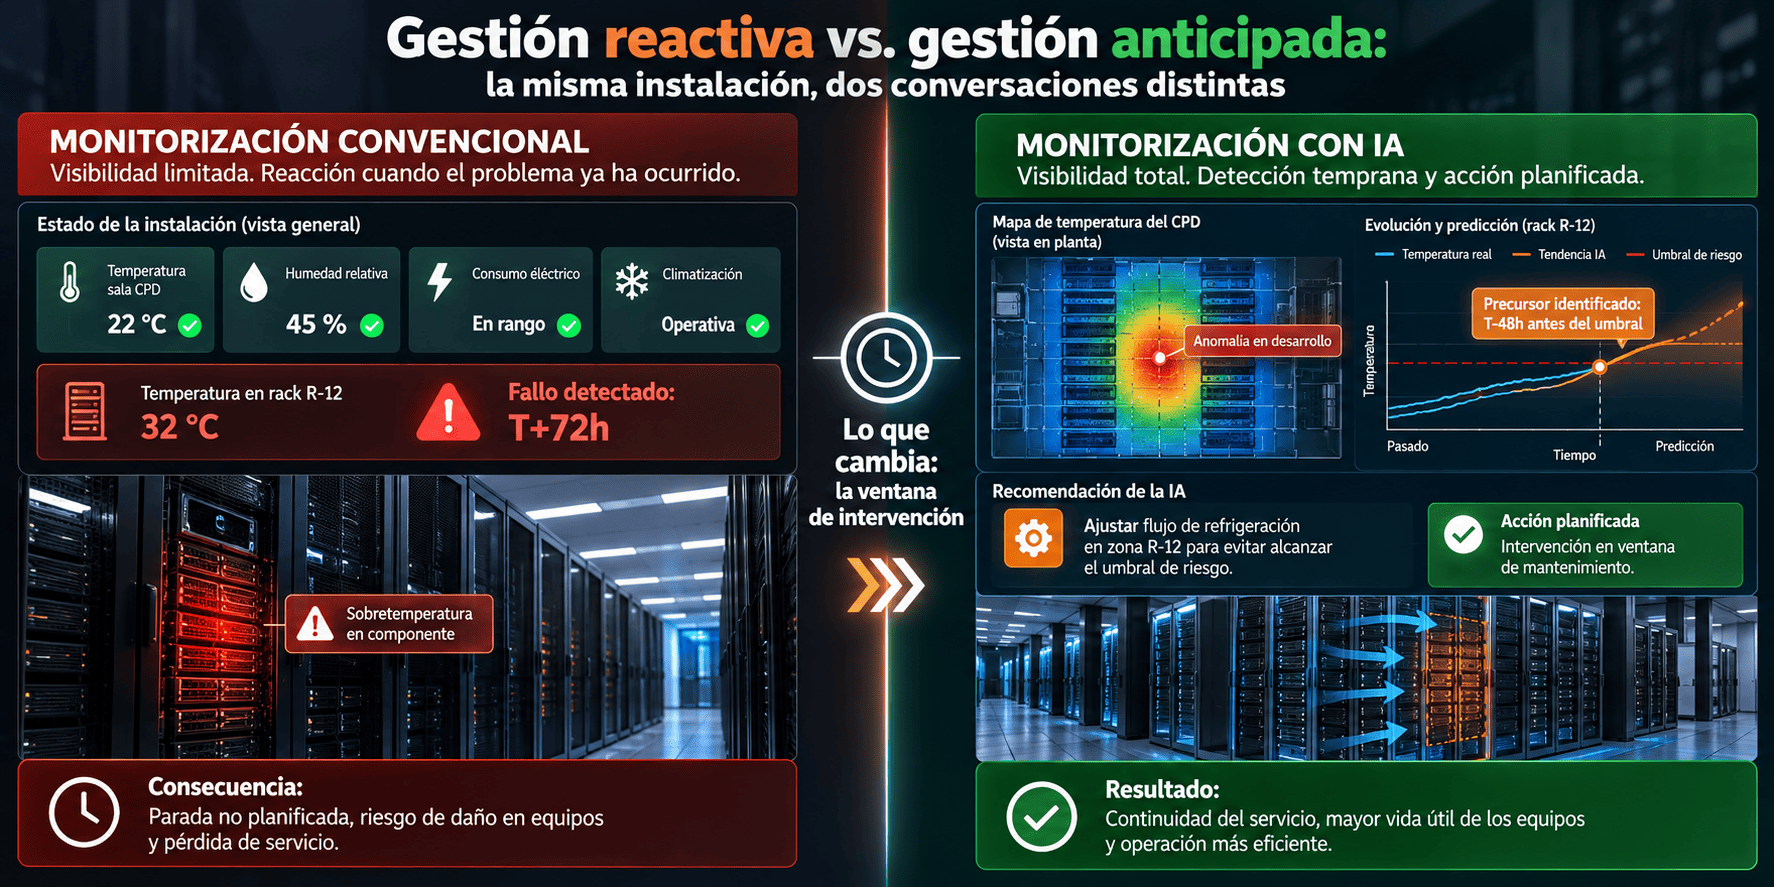
Lo que la implementación de un sistema de monitorización IA de servidores pone sobre la mesa, en términos operativos concretos, es la posibilidad de pasar de una gestión térmica basada en respuesta a incidentes a una gestión basada en anticipación estructurada. La diferencia entre las dos no es tecnológica: es estratégica.
¿Cuántos incidentes no planificados en tu infraestructura del último año podrían tener un origen térmico no detectado? Antes de responder, conviene tener datos.
Toma 5 minutos de tu tiempo antes de tomar acción. Descarga la guía de Consulta para cobertura térmica en racks.
Preguntas frecuentes
¿Cómo puedo saber si mi CPD tiene puntos calientes que los sensores actuales no están detectando?
Los indicadores indirectos más comunes son: componentes que fallan antes de su vida útil esperada sin causa identificada en los logs, reinicios inesperados en períodos de alta carga, y costes de refrigeración elevados sin correlación clara con la densidad de potencia instalada. Una auditoría térmica con sensores de alta densidad o una prueba piloto de monitorización IA puede confirmar o descartar el problema en días.
¿Por qué los sensores de temperatura convencionales no son suficientes para detectar fallos térmicos precozmente en los servidores?
Los sistemas convencionales miden estados puntuales en posiciones fijas con intervalos de muestreo de 5–15 minutos y generan alertas solo cuando se superan umbrales absolutos. Este diseño no captura variaciones de tendencia, correlaciones entre racks, ni patrones de precursores que operan en rangos de décimas de grado durante períodos prolongados. La detección precoz requiere análisis de trayectorias, no solo de valores instantáneos.
¿Qué volumen de datos procesa un sistema de monitorización IA de servidores y cómo se integra con la infraestructura existente?
Un CPD de tamaño medio puede generar varios millones de lecturas al día. Los sistemas de monitorización IA modernos se integran habitualmente con infraestructura de gestión existente mediante APIs estándar (SNMP, IPMI, DCIM), sin necesidad de sustituir los sensores instalados. La capa de inteligencia se añade sobre los datos ya disponibles, ampliando la capacidad analítica sin interferir con los sistemas operativos en producción.
¿Qué diferencia hay entre la monitorización IA de CPD y los sistemas DCIM tradicionales con análisis de tendencias?
Los sistemas DCIM con análisis de tendencias aplican reglas estadísticas predefinidas sobre datos históricos. Los modelos de IA aprenden el comportamiento específico de cada rack bajo cada condición operativa y detectan anomalías que se desvían de esa línea base individualizada, incluyendo patrones que no habrían sido codificados en ninguna regla predefinida. La diferencia práctica es la capacidad de detectar precursores de fallos no conocidos previamente.
¿Cómo contribuye el análisis predictivo de climatización basado en IA a los objetivos de eficiencia energética exigidos por la normativa de la UE?
La Directiva de Eficiencia Energética (DEE) y los requisitos del European Green Deal para CPD contemplan métricas de PUE (Power Usage Effectiveness) como indicadores de eficiencia. El análisis predictivo de climatización permite ajustar la capacidad de refrigeración a la demanda térmica real en lugar de a la demanda máxima posible, reduciendo el consumo de los sistemas CRAC/CRAH y mejorando directamente el PUE reportable.
📞 ¿Hablamos?
En Anukys te ayudamos a evaluar soluciones de monitorización adaptadas a tu instalación. Cuéntanos tu caso y estudiamos contigo las opciones.
Cuéntanos tu caso sin compromisoo llámanos: +34 657 274 067De la teoría a tu instalación
Inteligencia artificial industrial
Modelos que aguantan datos de campo: predicción, detección de anomalías y mantenimiento predictivo, auditables y en producción.
Ver la soluciónVer un caso real